
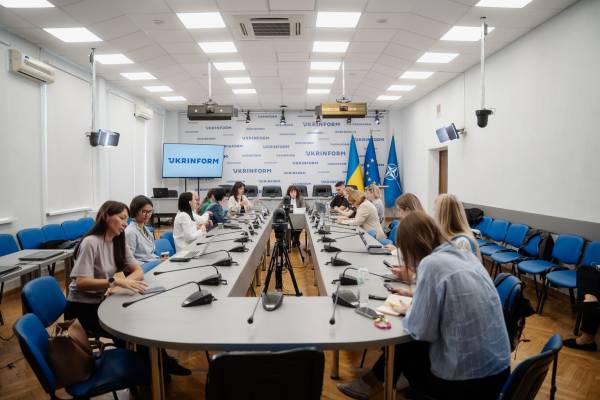
В Україні триває розробка законопроєкту про регулювання штучного інтелекту (ШІ). Мета — синхронізувати українське законодавство з європейським AI Act, що є одним із пріоритетів, озвучених Єврокомісією. Про це повідомив менеджер напряму штучного інтелекту Мінцифри Олег Дубно під час круглого столу, організованого ГО «Жінки в медіа» та «Репортери без кордонів» в «Укрінформі».
Захід зібрав представників загальнонаціональних, регіональних і локальних українських медіа, Нацради з питань телебачення і радіомовлення, Мінцифри, Лабораторії цифрової безпеки та інших фахівців галузі. Учасники обговорили шляхи етичного використання технологій ШІ в редакціях, етичні аспекти ШІ-контенту та реагування на його поширення в соціальних мережах.
Голова ГО «Жінки в медіа» Ліза Кузьменко у вступному слові звернула увагу на масове поширення діпфейк-відео, створених за допомогою ШІ з використанням образів українських журналісток. За її словами, організація вже передала перелік посилань на такі відео Центру протидії дезінформації при РНБО, що дозволило заблокувати їх на платформі TikTok.
Регіональна менеджерка «Репортерів без кордонів» Полін Мофре зазначила: «Зараз ми говоримо про те, як журналісти використовують штучний інтелект, але треба говорити і про те, як штучний інтелект може бути використано проти журналістів». Вона наголосила, що повна заборона ШІ не є виходом, натомість журналістів необхідно навчати користуватися цими технологіями, спираючись на професійні стандарти.
Спільно з «Жінки в медіа» організація розробила шаблон політики використання ШІ в редакціях та практичну інструкцію до нього. Власні політики за цим шаблоном уже затвердили «Рубрика», «Український тиждень», Starlight Media, «Frontliner», «Ґвара Медіа», радіо «Накипіло» та газета «Вість».
Мофре також навела дані глобального моніторингу: зі ста досліджених у різних країнах діпфейків понад 70% відео містили голоси або образи журналістів без їхньої згоди.
Радниця голови правління Суспільного мовлення Ангеліна Карякіна поділилася досвідом філіппінського мовника Rappler, який створив власну безпечну цифрову платформу та контрольовану велику мовну модель. Вона підкреслила: «Головним має бути принцип, де людина є на початку цього процесу, людина є вкінці, тобто якими би технологіями ми б не користувалися, маємо контролювати їх живим інтелектом, людськими ресурсами». Карякіна наголосила, що штучний інтелект має керуватися тими самими принципами і журналістськими стандартами, якими керуються редакції, а наявні правила та принципи роботи зі ШІ не повинні їм суперечити.
Старша юристка Лабораторії цифрової безпеки Тетяна Авдєєва зазначила, що стаття 33 закону «Про авторське право» вже визначає порядок використання неоригінальних об’єктів, згенерованих комп’ютерними системами, тож базове регулювання у сфері захисту інтелектуальної власності в Україні існує. Вона наголосила, що чинні обмеження, такі як заборона мови ворожнечі та захист прав дітей, також стосуються ШІ-контенту. Невичитаний текст може містити мову ворожнечі чи упередження, а зображення — підпадати під вікові обмеження 16+/18+ і порушувати статтю 42 закону «Про медіа».
Керівниця етико-правового напряму проєкту з розвитку української великої мовної моделі «Сяйво» Олена Андрієнко розповіла про труднощі пошуку балансу під час навчання моделі, зокрема щодо чутливої лексики, пов’язаної з мобілізацією, евакуацією та внутрішньо переміщеними особами. За її словами, модель має бути збалансованою, не допускати мови ворожнечі, водночас відповідати юридичним нормам та поточній ситуації в країні. Андрієнко наголосила, що використання національної моделі є питанням державної безпеки, тому важливо врахувати всі можливі нюанси.
Начальник відділу аналітичної роботи Нацради Дмитро Швидченко підсумував, що необхідно чітко визначити межі прийнятного використання ШІ у медіа. Однією з ключових загроз для України він назвав потенційне використання ШІ під час виборчого процесу, навівши приклад Румунії, де під час виборів було зафіксовано 25 тисяч акаунтів у TikTok і Facebook, які маніпулятивно поширювали діпфейки та згенеровані зображення на користь певних кандидатів.
У червні 2026 року стало відомо, що в Україні готують профільний євроінтеграційний закон про штучний інтелект, який Міністерство цифрової трансформації планує синхронізувати з європейським AI Act. Також повідомлялося, що українську велику мовну модель «Сяйво» планують зробити публічною у січні 2027 року.